

RAG とは?
検索拡張生成 (Retrieval-Augmented Generation、RAG) は、企業の社内ナレッジベースやドキュメントリポジトリなどの外部データソースから、関連性の高い最新の情報を大規模言語モデル (LLM) に提供する仕組みです。 適切なアクセス制御がないと、RAG パイプラインが機密情報を含むドキュメント (財務報告書、人事関連文書、戦略計画など) を取得し、本来そのデータにアクセスできないはずのユーザーに向けたレスポンスの生成に使ってしまうおそれがあります。その結果、深刻なデータ侵害やコンプライアンス違反を招きかねません。実際のアプリケーションには関係性に基づく複雑な権限が存在するため、ユーザーのロールによる単純なフィルタリングだけでは管理しきれないことが少なくありません。RAGの認可とは?
Auth0 Fine-Grained Authorization (FGA) は、認可ロジックをアプリケーションコードから切り離すことで、RAGパイプラインにリレーションシップベースのアクセス制御 (ReBAC) を実装します。複雑な権限ルールをアプリケーションに直接組み込むのではなく、認可モデルを定義し、リレーションシップデータをAuth0 FGAに保存します。これにより、アプリケーションはランタイムにAuth0 FGAへ問い合わせ、アクセス可否をリアルタイムで判断できるようになります。仕組み
Auth0 FGAをRAGパイプラインに統合すると、各ドキュメントはLLMに渡される前に、ユーザーの権限に基づいてチェックされます。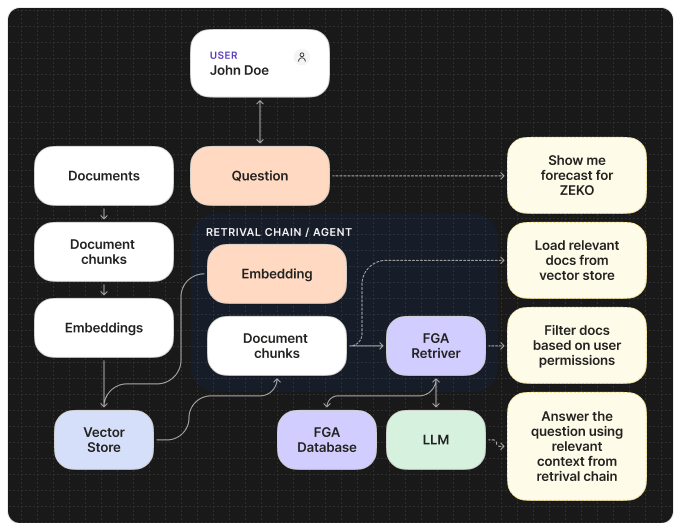
RAGの認可
1
認可モデル
まず、Auth0 FGAで認可モデルを定義します。このモデルでは、
オブジェクトの種類 (例:
document) 、ユーザーとオブジェクトの間に
成り立ちうる関係 (例:owner、editor、viewer) 、
そしてアクセスを制御するルールを指定します。2
関係の保存
権限はAuth0 FGAに「タプル」として保存します。タプルは中核となるデータ
要素で、
(user, relation, object)の形式で特定の関係を表します。たとえば、「user:anneは
document:2024-financialsのviewerである」といった関係です。3
取得とフィルタリング
ユーザーがAI agentにクエリを送信すると、バックエンドはまずベクトルデータベースから
関連するドキュメントを取得し、続いてAuth0 FGAを呼び出して権限を
チェックします。この呼び出しでは、「このユーザーはこれらのドキュメントを
閲覧できるか」を問い合わせます。当社のAIフレームワークSDKはこの処理を抽象化しているため、
リトリーバーツールにフィルターを組み込むだけで簡単に実装できます。
4
安全な取得
Auth0 FGAは、ユーザーにドキュメントへのアクセスが認可されているかどうかを判断します。
アプリケーションのバックエンドはその結果を使ってベクトルデータベースからの
検索結果をフィルタリングし、認可されたドキュメントのみをLLMに送信します。


